上一篇介绍了 Kanbox 现在能做什么。这篇写的是怎么把一个分享链接变成收藏。
最容易想到的做法是请求网页,再读标题和封面。但拿到页面以后,问题才开始:有的正文在 HTML 里,有的放在一段 JSON 中,有的返回登录提示,还有的分享地址只是用来打开原 App。
目前这部分代码主要在 LinkResolver.swift 和 Parsers.swift。这里以小红书、豆瓣、小宇宙和 GitHub 为例,讲的是当前实现,不涉及绕过登录或访问权限。
先从分享文案里找出链接
从其他 App 复制过来的经常不是一个干净网址,而是这样一段文字:
伊斯坦布尔的窗户有魔法!📷 我好像拍到了一扇扇通往...
https://xhslink.cn/o/2PMVMYCtPdE
来【小红书】围观这篇笔记!
解析入口先抽出 HTTP 或 HTTPS 链接,也处理没有协议头的裸域名。链接后面多出来的中文句号、引号和括号要清掉,不然它们可能被编码进地址,最后请求到一个不存在的页面。括号又不能一律删:网址本身可能就带一对括号,只处理多出来的那个。
剪贴板也有区别。有的 App 写入纯文本,有的只写入 URL 类型。现在的顺序是先找带链接的文本,再看 URL 和系统识别出的网页地址。有分享文案时尽量保留整段,因为链接前面的文字还能补一个标题。
提取这个标题不需要联网。页面没抓下来时,至少还知道刚才存的是什么;网络结果有标题,就用网络结果。链接后面的“来某某 App 看看”不拿来当标题。
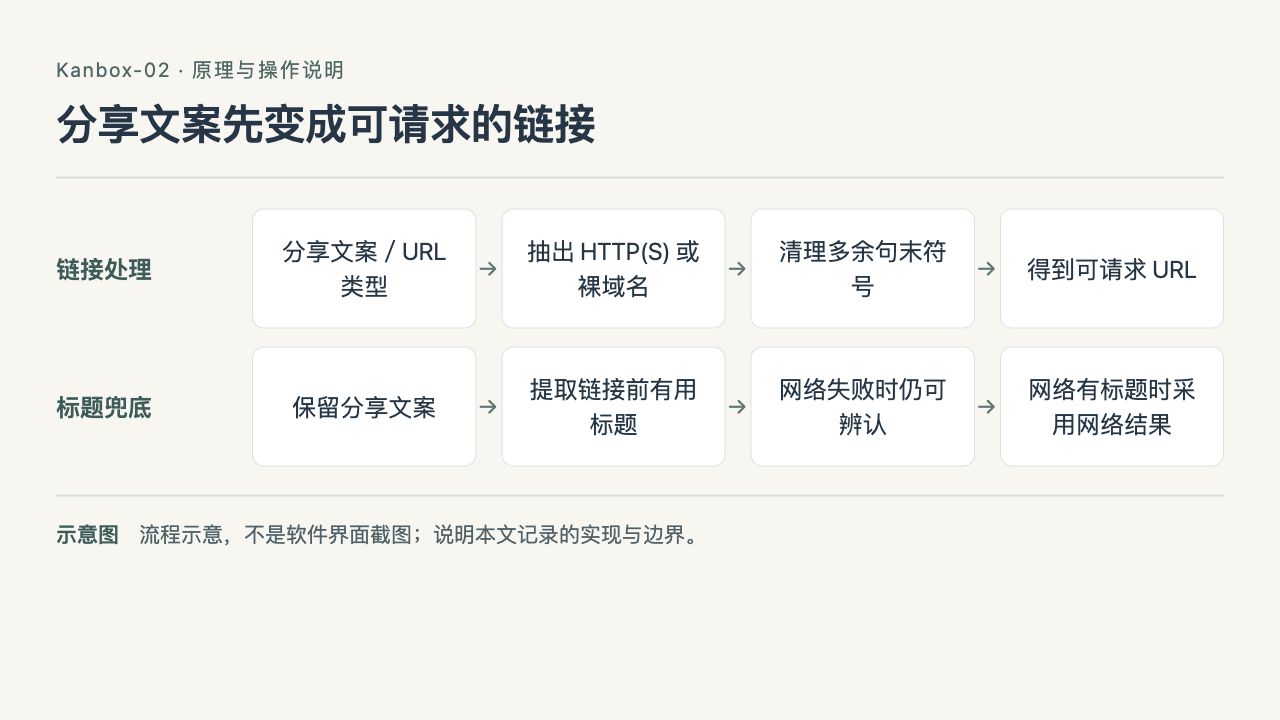
Kanbox-02 流程示意:分享文案先变成可请求的链接
先清理多出来的标点,不能把网址里本来合法的括号删掉。分享标题先作为本地兜底,网络拿到了标题再用网络结果。
抓到页面,再决定交给谁
小红书短链和一些分享地址会跳转。请求跟随重定向后,用最终域名选择解析器,原始地址和最终地址分别保留。
网络请求和字段提取是分开的。LinkResolver 负责请求、补充数据和失败处理,平台解析器接收 HTML,返回统一的 ParsedContent。这样改小红书字段时,不必同时修改网络层,也能把一份保存好的页面交给解析器做测试。
普通网页没有专用解析器时,先读结构化数据和标题、摘要、封面等元信息。Open Graph提供的就是这类预览信息,拿到它不代表拿到了完整文章。
对文章页,代码会尝试抽正文:优先找 <article>,去掉导航、页脚和脚本,再按文字量、标点和链接密度挑内容块。某些动态网页只有外层页面结构,需要在隔离、无登录态的 WebKit 中等页面加载后再读正文。这条通用处理路径不会套到已有专用解析器的平台上。

Kanbox-02 流程示意:网络层拿页面,解析器取字段
请求、平台分派和字段提取分开。专用平台解析器不套通用正文提取;普通网页先读预览与结构化数据,动态正文才尝试隔离、无登录态 WebKit。
四个平台,四种处理方法
| 来源 | 当前主要读取位置 | 补充或降级处理 |
|---|---|---|
| 小红书 | 页面中的笔记初始数据 | 没有笔记数据时检查登录提示,必要时只留链接 |
| 豆瓣 | 公开移动条目页 | 将 App 分享路由映射到条目页,电影再补演职员 |
| 小宇宙 | 单集页面的 __NEXT_DATA__ | 再尝试 PodcastEpisode 数据和页面元信息 |
| GitHub | 仓库页预览与公开 REST API | 分别补仓库资料、README;失败时保留已有结果 |
小红书:封面之外,还要拿到整组图
上一篇那组伊斯坦布尔照片有 11 张图。只读一个封面字段,收藏里就只会剩一张。
当前解析器优先读取页面初始数据里的笔记对象,从里面取标题、作者、正文、话题和有顺序的图片列表。图片去重时保留原有顺序,不用一个无序集合直接代替。
明确的降级条件是:页面有 window.__INITIAL_STATE__,却找不到笔记对象时,不继续把首页 Logo 当成笔记封面。返回的可能是登录页、笔记已删除后的页面,或者只有页面框架、没有正文的结果。此时保留链接,并留下解析说明。
没有这段初始数据的个别页面,才继续看预览标签。拿到一张带“小红书”字样的图,不足以证明这条笔记已经解析成功。
视频另外处理。页面可能给出媒体定位,但能否播放还要在使用时检查;一个地址过期,也不应该导致已经存好的标题和正文一起丢掉。
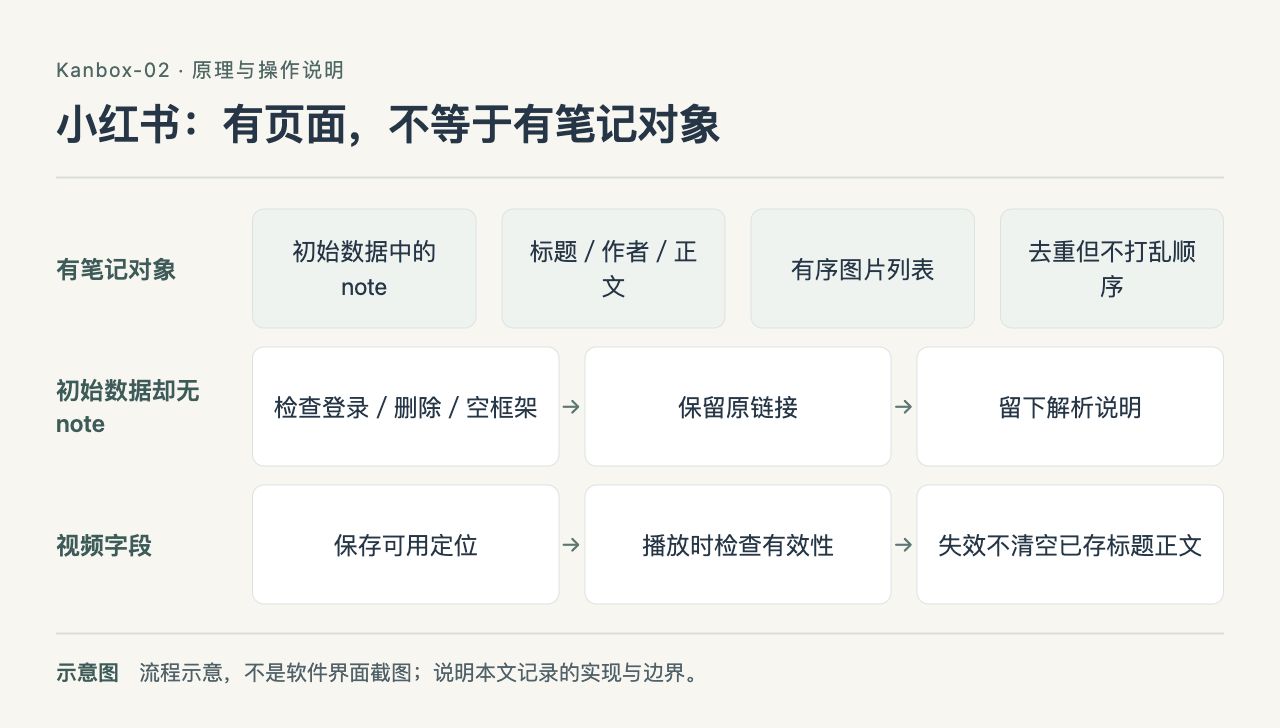
Kanbox-02 流程示意:小红书:有页面,不等于有笔记对象
重点是有没有这条笔记的数据,而不是网页上有没有一张图。图片列表保留顺序;缺少笔记对象时留下链接和说明,不能拿首页 Logo 充当封面。

Kanbox-02 界面截图:伊斯坦布尔笔记的 11 张图片浏览器
打开“伊斯坦布尔的窗户有魔法!”这条收藏,图片查看器显示第 1 张,共 11 张,并列出这张 JPEG 的尺寸和大小。它展示的是笔记里的原始图片,不是另做的分享卡;整组图片拿到后,才有逐张浏览、保存和分享的入口。截图来自博客专用模拟器中的公开链接样本。
豆瓣:分享地址不一定是资料页
以《三傻大闹宝莱坞》为例,从 App 分享出来的是:
https://www.douban.com/doubanapp/dispatch/movie/3793023?dt_dapp=1
这个 dispatch 页面主要用来跳转。当前代码识别固定的类型和数字 ID,再请求豆瓣自己的公开移动条目页:
https://m.douban.com/movie/subject/3793023/
电影名称、简介、海报、评分和基本资料从条目页读。演职员列表不是静态页面里现成的一整段文字,还要补查该移动页面使用的公开接口。补查失败时,保留已经读到的电影资料。
这里不能把分享链接参数中的任意地址直接拿来请求。现在的映射限定在豆瓣域名、已识别路由和数字 ID 内。下架或错误页也不能因为有一张导航图,就被当成电影资料。
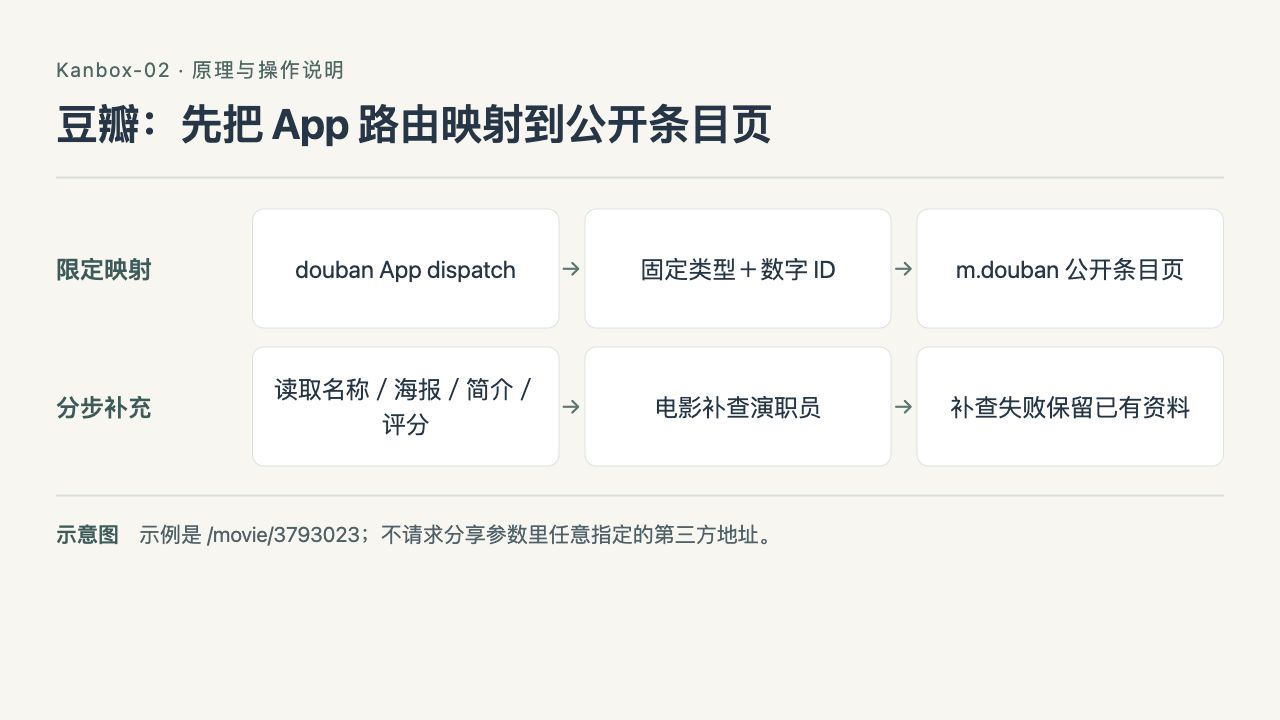
Kanbox-02 流程示意:豆瓣:先把 App 路由映射到公开条目页
只识别豆瓣域名、已知路由和数字 ID。先保存条目资料,再补查演职员;第二次请求失败,不把已经拿到的电影资料清空。
小宇宙:节目说明和音频分别保存
小宇宙的单集页里,__NEXT_DATA__ 通常比页面摘要更完整。当前代码从 episode 对象读标题、shownotes、节目名称、封面、发布时间,以及页面提供的音频地址;能拿到单集 ID 时,也会核对是不是正在请求的那一期。
shownotes 中的段落和列表会整理成可读文本,而不是把 HTML 标签原样塞进收藏。没有这份数据时,再尝试 PodcastEpisode 结构化数据,最后退到页面元信息。
音频放在 audioUrl,不放进 videoUrl。它们可能都能用播放器打开,但在收藏列表里不应该显示成同一种媒体。
标题和说明读到了、音频没有读到,也可以留下这期节目,只是要明确提示缺少在线播放地址。有音频地址同样不等于已经离线下载,播放时仍可能需要网络。

Kanbox-02 流程示意:小宇宙:节目文字与音频是两组字段
按单集 ID 核对身份,先读 episode 数据,再尝试结构化数据和页面预览。音频缺失仍能保留这期节目,但不能显示成已下载,或塞进 videoUrl。
GitHub:不用文件列表冒充 README
仓库网页里有导航、文件列表和 README 容器,直接把大段 HTML 转成文字,未必能得到有用的项目介绍。
Kanbox 先确认仓库身份和页面预览,再分别请求仓库资料接口与 README 接口。公开仓库可以走匿名请求。仓库资料用于补简介、语言、主题、许可证和统计,README 单独保存。
返回结果还要核对 owner 和仓库名,避免把别的项目合并进来。README 也设了长度限制,截断时留下标记。API 受限或 README 没取到,已有的仓库预览不会被清空。
这部分目前针对仓库根地址。一个 Issue、文件页或其他 GitHub 路径,不能直接当成仓库根页面处理。
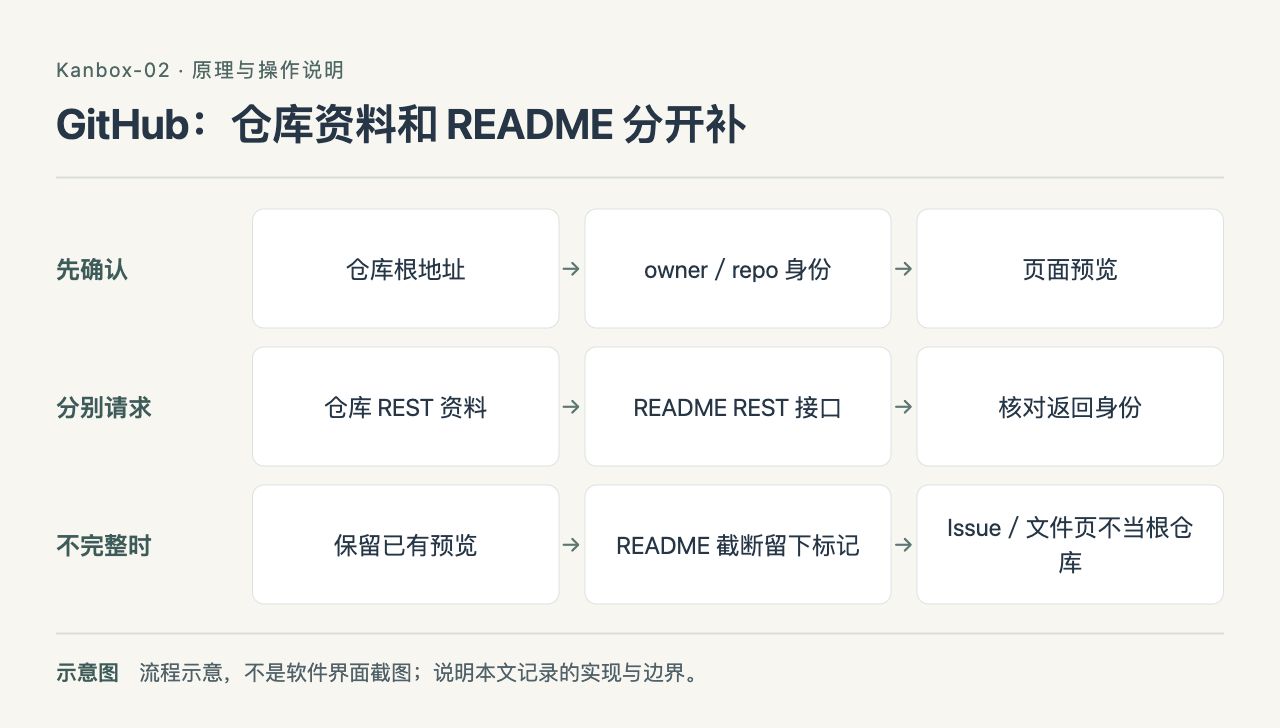
Kanbox-02 流程示意:GitHub:仓库资料和 README 分开补
先确认仓库身份,再分别补资料与 README。返回结果要对上 owner 和仓库名;API 受限时仍保留预览,不用文件列表假装 README。
解析失败后,收藏怎么留下来
统一的解析结果里有 isResolved 和 note 两个字段。前者表示解析器是否拿到了可用结果,后者记录缺少媒体、需要登录等情况。两者要一起看:isResolved = true 也可能只是解析出部分内容,不是所有字段都齐了。
断网、超时或页面不可访问时,解析层返回只包含链接等基础信息的结果,带上失败原因;如果分享文案里有标题,再补进去。设置页的解析统计也会区分带说明的部分结果和无说明的成功结果。
HTTP 错误要先挡住。403 或 404 页面也可能有标题和整段 HTML,不能因此把“Access Denied”存成文章标题,并把失败标记清掉。
单次页面响应最多读 3 MiB,读到上限就停止传输,不是先下载完整文件再截取。请求超时配置为 20 秒,资源超时为 30 秒;这些限制针对单次网络请求,补查资料的整个过程不保证在 20 秒内结束。
解析失败和保存失败也得分开。系统分享扩展把结果写入 App Group 的待入库队列,一条内容一个文件,原子写入后回读确认。主 App 激活后再写进 SwiftData,确认保存成功才移除队列里的那一条。写队列或数据库失败,仍然要报错,不能因为解析器返回了结果就提示“已保存”。

Kanbox-02 流程示意:解析结果、队列写入、数据库保存分开确认
解析失败可以保留链接,但保存动作本身失败仍然要报错。只有 SwiftData 保存确认后,才删除对应待入库文件,不能“网络有返回”就提示已保存。
重新解析,不把用户的修改冲掉
详情页有手动重新解析入口。它会重新请求网络,不是重复展示上一次失败的结果;已经解析过的内容也能用它刷新失效的媒体信息。
但重试不能直接拿一个新的结果覆盖整条收藏。用户可能改过标题、写过正文,也可能在等待网络返回时又编辑了一次。
当前做法是:请求前记下条目 ID、原链接和修订时间;返回后重新读取条目,确认没有被删除或改动,再应用允许更新的解析字段。用户的标题、正文、标签和收藏状态保留。新结果没有图片时保留旧图;有新的非空图片列表时,更新图片列表。
网络失败不写入,条目在等待期间发生变化也不写入。最后保存失败时,恢复应用这次更新前的内容,再提示重试。
媒体地址也有有效期。比如 Instagram 的部分视频地址带签名,播放或保存前会重新读取同一条内容的 embed 页面;这和重新解析整条收藏是两件事。官方 HTML 播放器、稳定原帖地址和实际视频文件,也不能因为都放在播放相关字段里,就一律当成可下载的文件。

Kanbox-02 流程示意:重新解析先核对修订,再更新允许的字段
请求出去后,用户可能又改过内容。返回时重新读取和比较身份、链接与修订时间;不满足条件就不写,保存失败则恢复这次更新前的内容。
测试里要留下哪些页面
工程里已经有页面样本解析测试和模拟网络测试。小宇宙测试检查 shownotes、音频字段与不可信媒体域名;GitHub 测试检查仓库身份匹配和 README 截断;网络层测试检查重定向、3 MiB 上限、第一次失败后的新请求,以及带 HTML 的 HTTP 错误不能变成成功结果。
这些测试能检查字段提取和代码边界,不能保证平台下一次改版后仍然可用。遇到失效链接时,还得看实际返回的是正常内容、登录提示、空页面,还是错误响应。修改解析器以后,需要同时检查旧样本和新的实际页面。

Kanbox-02 流程示意:样本测试与真实页面检查,都要留一份
保存页面样本便于稳定检查字段,模拟网络能覆盖错误和重试;平台实际返回值仍可能改变,需要新页面检查。没有把测试通过写成平台永远可用。
目前先这样处理:能读到多少就保存多少,缺了什么留下说明,再给用户一个不破坏旧内容的重试入口。平台限制仍然存在,这篇记录的是 2026 年 10 月 2 日的实现,不把页面内的数据结构当作平台承诺长期提供的 API。