지난 글에서는 Kanbox가 지금 무엇을 할 수 있는지 소개했다. 이번 글은 공유 링크 하나가 어떻게 즐겨찾기가 되는지를 다룬다.
가장 먼저 떠올릴 수 있는 방법은 웹페이지를 요청한 뒤 제목과 커버를 읽는 것이다. 하지만 페이지를 받아온 다음부터가 진짜 문제다. 어떤 본문은 HTML 안에 있고, 어떤 것은 JSON 덩어리 안에 들어 있으며, 어떤 페이지는 로그인 안내를 돌려주고, 또 어떤 공유 주소는 그저 원래 앱을 여는 용도일 뿐이다.
현재 이 부분의 코드는 주로 LinkResolver.swift와 Parsers.swift에 있다. 여기서는 샤오홍슈, 더우반, 샤오위저우, GitHub를 예로 들어 현재 구현을 설명하며, 로그인이나 접근 권한을 우회하는 방법은 다루지 않는다.
먼저 공유 문구에서 링크를 찾아낸다
다른 앱에서 복사해 온 것은 깔끔한 URL이 아니라 흔히 이런 텍스트다:
이스탄불의 창문에는 마법이 있다! 📷 나는 마치 어딘가로 통하는 창문들을 찍은 것 같아...
https://xhslink.cn/o/2PMVMYCtPdE
【샤오홍슈】에서 이 노트를 구경하세요!
파서 진입점은 먼저 HTTP 또는 HTTPS 링크를 추출하고, 프로토콜 헤더가 없는 맨 도메인도 처리한다. 링크 뒤에 붙은 중국어 마침표, 따옴표, 괄호는 제거해야 한다. 그대로 두면 주소에 인코딩되어 존재하지 않는 페이지를 요청하게 될 수 있다. 다만 괄호를 무조건 지워서는 안 된다. URL 자체에 괄호 한 쌍이 포함될 수 있으므로, 남는 것만 처리해야 한다.
클립보드도 차이가 있다. 어떤 앱은 일반 텍스트를 쓰고, 어떤 앱은 URL 타입만 쓴다. 현재 순서는 링크가 포함된 텍스트를 먼저 찾고, 그다음 URL과 시스템이 인식한 웹 주소를 본다. 공유 문구가 있으면 되도록 통째로 보존하는데, 링크 앞의 텍스트로 제목을 보완할 수 있기 때문이다.
이 제목을 추출하는 데는 네트워크가 필요 없다. 페이지를 못 가져왔더라도 최소한 방금 무엇을 저장했는지는 알 수 있다. 네트워크 결과에 제목이 있으면 그것을 쓴다. 링크 뒤의 "○○ 앱에서 보기" 같은 문구는 제목으로 쓰지 않는다.
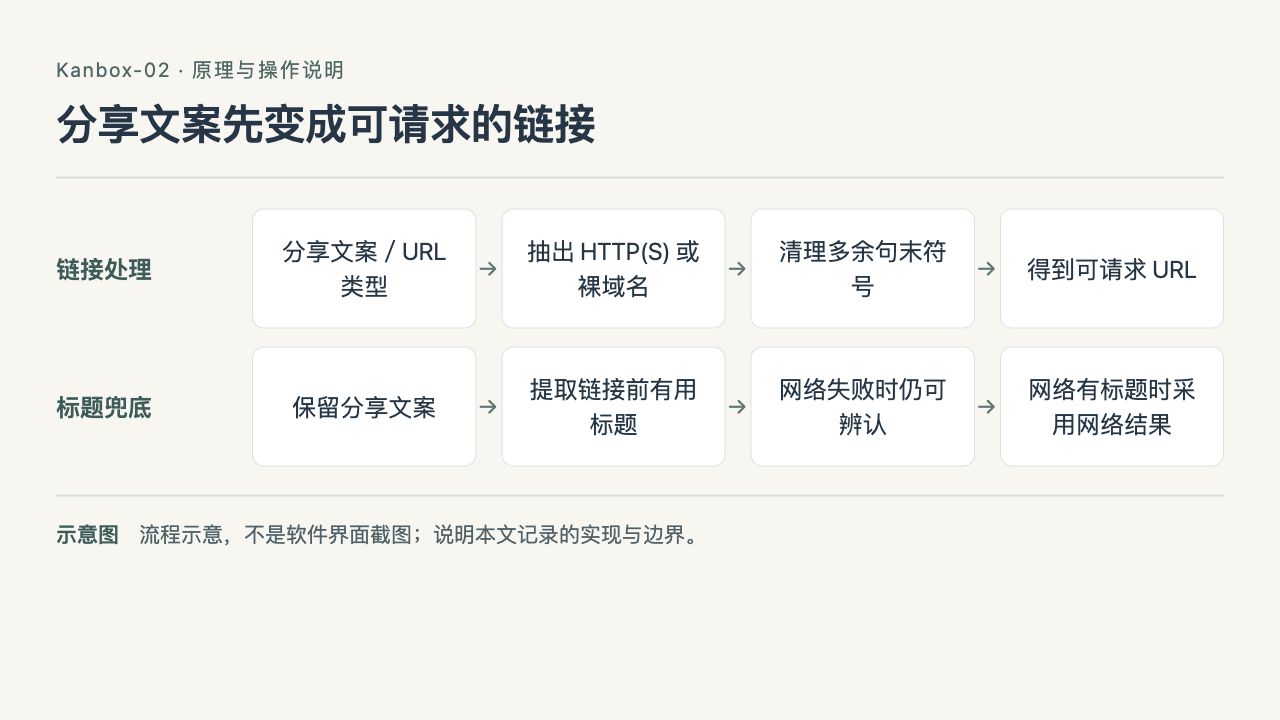
Kanbox-02 흐름도: 공유 문구가 먼저 요청 가능한 링크가 된다
먼저 남는 문장부호를 정리하되, URL에 원래 있던 합법적인 괄호는 지우지 않는다. 공유 제목은 우선 로컬 폴백으로 쓰고, 네트워크에서 제목을 받아오면 네트워크 결과를 사용한다.
페이지를 가져온 뒤, 누구에게 맡길지 정한다
샤오홍슈 단축 링크와 일부 공유 주소는 리다이렉트된다. 요청이 리다이렉트를 따라간 뒤 최종 도메인으로 파서를 선택하고, 원래 주소와 최종 주소를 각각 보존한다.
네트워크 요청과 필드 추출은 분리되어 있다. LinkResolver는 요청, 데이터 보완, 실패 처리를 담당하고, 플랫폼 파서는 HTML을 받아 통일된 ParsedContent를 반환한다. 덕분에 샤오홍슈 필드를 고칠 때 네트워크 계층을 함께 수정할 필요가 없고, 저장해 둔 페이지를 파서에 넘겨 테스트할 수도 있다.
일반 웹페이지에 전용 파서가 없으면 먼저 구조화 데이터와 제목, 요약, 커버 같은 메타 정보를 읽는다. Open Graph가 제공하는 것이 바로 이런 미리보기 정보인데, 그것을 얻었다고 해서 글 전체를 얻은 것은 아니다.
글 페이지의 경우 코드는 본문 추출을 시도한다. <article>을 우선 찾고, 내비게이션, 푸터, 스크립트를 제거한 뒤 텍스트 양, 문장부호, 링크 밀도를 기준으로 콘텐츠 블록을 고른다. 일부 동적 웹페이지는 바깥 페이지 구조만 있어서, 격리된 비로그인 상태의 WebKit에서 페이지 로딩이 끝난 뒤에야 본문을 읽을 수 있다. 이 범용 처리 경로는 이미 전용 파서가 있는 플랫폼에는 적용되지 않는다.

Kanbox-02 흐름도: 네트워크 계층이 페이지를 가져오고, 파서가 필드를 뽑는다
요청, 플랫폼 분배, 필드 추출은 분리되어 있다. 전용 플랫폼 파서에는 범용 본문 추출을 적용하지 않는다. 일반 웹페이지는 먼저 미리보기와 구조화 데이터를 읽고, 동적 본문일 때만 격리된 비로그인 WebKit을 시도한다.
네 플랫폼, 네 가지 처리 방식
| 출처 | 현재 주로 읽는 위치 | 보완 또는 폴백 처리 |
|---|---|---|
| 샤오홍슈 | 페이지 내 노트 초기 데이터 | 노트 데이터가 없으면 로그인 안내를 확인하고, 필요하면 링크만 남김 |
| 더우반 | 공개 모바일 항목 페이지 | 앱 공유 라우트를 항목 페이지로 매핑하고, 영화면 출연진·제작진을 추가 |
| 샤오위저우 | 단일 에피소드 페이지의 __NEXT_DATA__ | 이어서 PodcastEpisode 데이터와 페이지 메타 정보를 시도 |
| GitHub | 저장소 페이지 미리보기와 공개 REST API | 저장소 정보와 README를 각각 보완하고, 실패하면 기존 결과를 유지 |
샤오홍슈: 커버 말고 이미지 전체를 가져와야 한다
지난 글의 이스탄불 사진은 11장이었다. 커버 필드 하나만 읽으면 즐겨찾기에는 한 장만 남는다.
현재 파서는 페이지 초기 데이터의 노트 객체를 우선 읽고, 거기서 제목, 작성자, 본문, 토픽, 순서가 있는 이미지 목록을 가져온다. 이미지 중복 제거 시 원래 순서를 유지하며, 순서 없는 집합으로 바로 대체하지 않는다.
명확한 폴백 조건은 이렇다. 페이지에 window.__INITIAL_STATE__가 있는데 노트 객체를 찾을 수 없으면, 홈페이지 로고를 노트 커버로 계속 쓰지 않는다. 반환된 것이 로그인 페이지일 수도 있고, 노트가 삭제된 뒤의 페이지일 수도 있고, 페이지 틀만 있고 본문이 없는 결과일 수도 있다. 이때는 링크를 남기고 파싱 설명도 함께 남긴다.
이 초기 데이터가 없는 일부 페이지에 한해서만 미리보기 태그를 계속 본다. "샤오홍슈"라는 글자가 들어간 이미지를 하나 얻었다고 해서 그 노트가 제대로 파싱되었다고 볼 수는 없다.
동영상은 따로 처리한다. 페이지가 미디어 위치를 알려줄 수 있지만 재생 가능 여부는 사용할 때 확인해야 하고, 주소 하나가 만료되었다고 해서 이미 저장된 제목과 본문까지 함께 버려서는 안 된다.
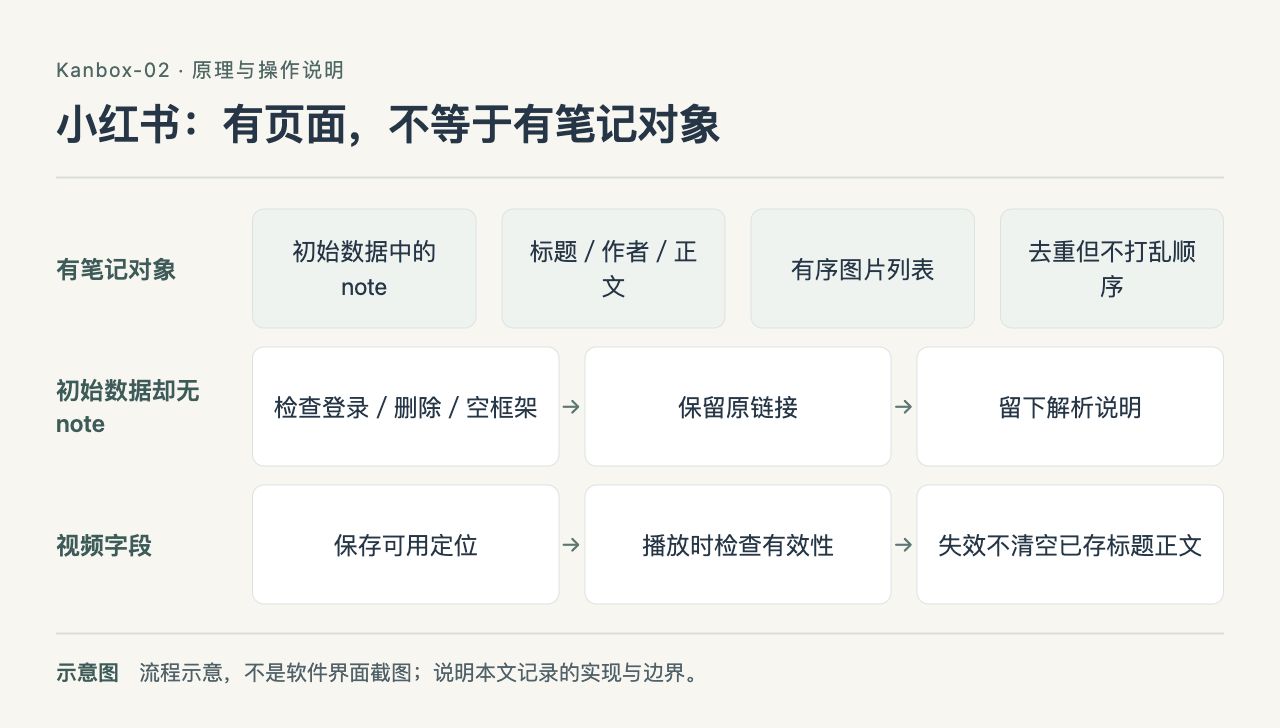
Kanbox-02 흐름도: 샤오홍슈: 페이지가 있다고 노트 객체가 있는 건 아니다
중요한 것은 이 노트의 데이터가 있느냐이지, 웹페이지에 이미지가 하나 있느냐가 아니다. 이미지 목록은 순서를 유지하고, 노트 객체가 없으면 링크와 설명을 남기며, 홈페이지 로고를 커버로 대신 써서는 안 된다.

Kanbox-02 화면 캡처: 이스탄불 노트의 11장 이미지 뷰어
"이스탄불의 창문에는 마법이 있다!" 즐겨찾기를 열면 이미지 뷰어가 1번째 장, 총 11장을 표시하고 이 JPEG의 크기와 용량을 보여준다. 이것은 노트 안의 원본 이미지를 보여주는 것이지 따로 만든 공유 카드가 아니다. 이미지 전체를 가져와야 한 장씩 넘겨보고 저장하고 공유하는 입구가 생긴다. 캡처는 블로그 전용 시뮬레이터에서 공개 링크 샘플로 찍은 것이다.
더우반: 공유 주소가 반드시 정보 페이지인 것은 아니다
《세 얼간이》를 예로 들면, 앱에서 공유한 주소는 이렇다:
https://www.douban.com/doubanapp/dispatch/movie/3793023?dt_dapp=1
이 dispatch 페이지는 주로 이동용이다. 현재 코드는 고정된 타입과 숫자 ID를 인식한 뒤 더우반 자체의 공개 모바일 항목 페이지를 요청한다:
https://m.douban.com/movie/subject/3793023/
영화 제목, 소개, 포스터, 평점, 기본 정보는 항목 페이지에서 읽는다. 출연진·제작진 목록은 정적 페이지에 완성된 텍스트로 있는 것이 아니라, 해당 모바일 페이지가 사용하는 공개 인터페이스를 추가로 조회해야 한다. 추가 조회가 실패하면 이미 읽은 영화 정보는 유지한다.
여기서 공유 링크 파라미터에 있는 임의의 주소를 그대로 요청해서는 안 된다. 현재 매핑은 더우반 도메인, 인식된 라우트, 숫자 ID 안으로 제한된다. 삭제되었거나 잘못된 페이지도 내비게이션 이미지가 하나 있다는 이유로 영화 정보로 취급되어서는 안 된다.
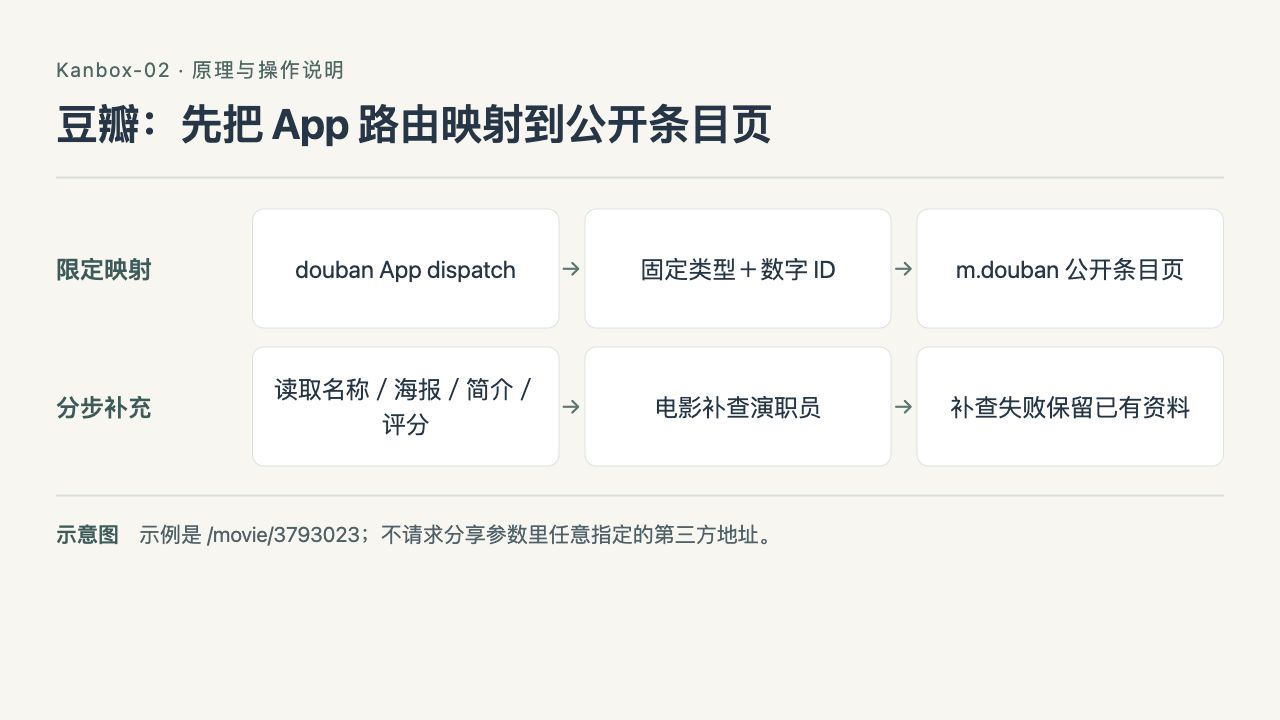
Kanbox-02 흐름도: 더우반: 먼저 앱 라우트를 공개 항목 페이지로 매핑한다
더우반 도메인, 알려진 라우트, 숫자 ID만 인식한다. 항목 정보를 먼저 저장한 뒤 출연진·제작진을 추가 조회하고, 두 번째 요청이 실패해도 이미 가져온 영화 정보를 비우지 않는다.
샤오위저우: 프로그램 설명과 오디오는 따로 저장한다
샤오위저우의 단일 에피소드 페이지에서는 __NEXT_DATA__가 보통 페이지 요약보다 더 완전하다. 현재 코드는 episode 객체에서 제목, shownotes, 프로그램 이름, 커버, 발행 시각, 페이지가 제공하는 오디오 주소를 읽는다. 에피소드 ID를 얻을 수 있으면 지금 요청하는 회차가 맞는지도 확인한다.
shownotes의 문단과 목록은 읽을 수 있는 텍스트로 정리하며, HTML 태그를 그대로 즐겨찾기에 밀어 넣지 않는다. 이 데이터가 없으면 PodcastEpisode 구조화 데이터를 시도하고, 마지막으로 페이지 메타 정보로 물러난다.
오디오는 audioUrl에 넣고 videoUrl에는 넣지 않는다. 둘 다 플레이어로 열 수 있을지 모르지만, 즐겨찾기 목록에서 같은 종류의 미디어로 표시되어서는 안 된다.
제목과 설명은 읽었는데 오디오를 읽지 못했더라도 이 회차를 남길 수 있다. 다만 온라인 재생 주소가 없다는 점을 분명히 알려야 한다. 오디오 주소가 있다고 해서 이미 오프라인 다운로드가 된 것도 아니며, 재생 시 여전히 네트워크가 필요할 수 있다.

Kanbox-02 흐름도: 샤오위저우: 프로그램 텍스트와 오디오는 두 묶음의 필드다
에피소드 ID로 신원을 확인하고, 먼저 episode 데이터를 읽은 뒤 구조화 데이터와 페이지 미리보기를 시도한다. 오디오가 없어도 이 회차는 남길 수 있지만, 다운로드된 것으로 표시하거나 videoUrl에 밀어 넣어서는 안 된다.
GitHub: 파일 목록으로 README를 대신하지 않는다
저장소 웹페이지에는 내비게이션, 파일 목록, README 컨테이너가 있다. 큰 HTML 덩어리를 그대로 텍스트로 바꾼다고 해서 유용한 프로젝트 소개가 나오는 것은 아니다.
Kanbox는 먼저 저장소 신원과 페이지 미리보기를 확인한 뒤, 저장소 정보 인터페이스와 README 인터페이스를 각각 요청한다. 공개 저장소는 익명 요청으로 가능하다. 저장소 정보는 소개, 언어, 토픽, 라이선스, 통계를 보완하는 데 쓰고, README는 따로 저장한다.
반환 결과는 owner와 저장소 이름도 대조해서 다른 프로젝트가 섞여 들어오지 않게 한다. README에도 길이 제한을 두고, 잘릴 때는 표시를 남긴다. API가 제한되거나 README를 못 가져왔더라도 이미 있는 저장소 미리보기는 비우지 않는다.
이 부분은 현재 저장소 루트 주소를 대상으로 한다. Issue, 파일 페이지, 기타 GitHub 경로는 저장소 루트 페이지로 바로 처리할 수 없다.
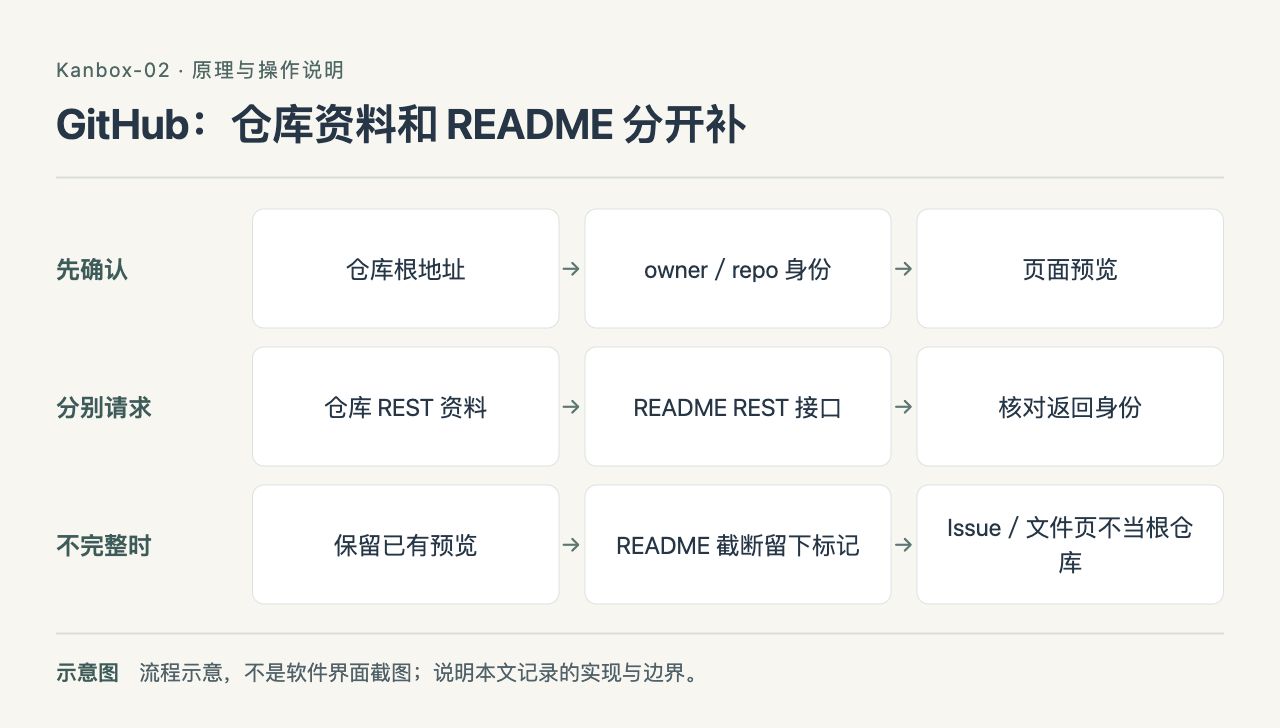
Kanbox-02 흐름도: GitHub: 저장소 정보와 README를 따로 보완한다
먼저 저장소 신원을 확인한 뒤 정보와 README를 각각 보완한다. 반환 결과는 owner와 저장소 이름이 맞아야 하고, API가 제한되어도 미리보기는 유지하며, 파일 목록으로 README인 척하지 않는다.
파싱이 실패해도 즐겨찾기는 어떻게 남는가
통일된 파싱 결과에는 isResolved와 note 두 필드가 있다. 전자는 파서가 쓸 만한 결과를 얻었는지를 나타내고, 후자는 미디어 누락, 로그인 필요 같은 상황을 기록한다. 둘을 함께 봐야 한다. isResolved = true여도 일부 내용만 파싱된 것일 수 있고, 모든 필드가 다 채워진 것은 아니다.
네트워크가 끊기거나, 타임아웃이 나거나, 페이지에 접근할 수 없을 때 파싱 계층은 링크 등 기본 정보만 담은 결과를 실패 이유와 함께 반환한다. 공유 문구에 제목이 있으면 그것도 채워 넣는다. 설정 페이지의 파싱 통계도 설명이 있는 부분 결과와 설명 없는 성공 결과를 구분한다.
HTTP 오류는 먼저 막아야 한다. 403이나 404 페이지에도 제목과 HTML 전체가 있을 수 있으므로, 그 때문에 "Access Denied"를 글 제목으로 저장하고 실패 표시를 지워서는 안 된다.
단일 페이지 응답은 최대 3 MiB까지 읽고, 상한에 도달하면 전송을 중단한다. 파일 전체를 내려받은 뒤 자르는 방식이 아니다. 요청 타임아웃은 20초, 리소스 타임아웃은 30초로 설정되어 있다. 이 제한은 단일 네트워크 요청에 대한 것이며, 정보를 추가 조회하는 전체 과정이 20초 안에 끝난다고 보장하지는 않는다.
파싱 실패와 저장 실패도 구분해야 한다. 시스템 공유 확장은 결과를 App Group의 대기 큐에 쓴다. 콘텐츠 하나에 파일 하나이고, 원자적으로 쓴 뒤 다시 읽어 확인한다. 메인 앱이 활성화된 뒤 SwiftData에 기록하고, 저장 성공을 확인한 다음에야 큐에서 그 항목을 제거한다. 큐나 데이터베이스 쓰기가 실패하면 여전히 오류를 내야 하며, 파서가 결과를 반환했다는 이유로 "저장됨"이라고 알려서는 안 된다.

Kanbox-02 흐름도: 파싱 결과, 큐 쓰기, 데이터베이스 저장을 따로 확인한다
파싱이 실패하면 링크는 남길 수 있지만, 저장 동작 자체가 실패하면 여전히 오류를 내야 한다. SwiftData 저장이 확인된 뒤에만 해당 대기 파일을 삭제하며, "네트워크가 응답했다"는 이유로 저장됨이라고 알려서는 안 된다.
다시 파싱하되, 사용자의 수정을 덮어쓰지 않는다
상세 페이지에는 수동 재파싱 입구가 있다. 이것은 네트워크를 다시 요청하는 것이지, 지난번 실패 결과를 반복해서 보여주는 것이 아니다. 이미 파싱된 콘텐츠도 이걸로 만료된 미디어 정보를 새로 고칠 수 있다.
하지만 재시도가 새 결과를 그대로 가져다 즐겨찾기 전체를 덮어써서는 안 된다. 사용자가 제목을 고쳤을 수도, 본문을 썼을 수도, 네트워크 응답을 기다리는 동안 또 한 번 편집했을 수도 있다.
현재 방식은 이렇다. 요청 전에 항목 ID, 원래 링크, 수정 시각을 기록한다. 응답이 오면 항목을 다시 읽어 삭제되거나 변경되지 않았는지 확인한 뒤, 갱신이 허용된 파싱 필드만 적용한다. 사용자의 제목, 본문, 태그, 즐겨찾기 상태는 유지한다. 새 결과에 이미지가 없으면 기존 이미지를 유지하고, 비어 있지 않은 새 이미지 목록이 있으면 이미지 목록을 갱신한다.
네트워크가 실패하면 쓰지 않고, 대기 중에 항목이 바뀌어도 쓰지 않는다. 마지막 저장이 실패하면 이번 갱신 전 내용으로 되돌린 뒤 다시 시도하라고 알린다.
미디어 주소에도 유효기간이 있다. 예를 들어 Instagram의 일부 동영상 주소에는 서명이 붙어 있어서, 재생하거나 저장하기 전에 같은 콘텐츠의 embed 페이지를 다시 읽는다. 이것은 즐겨찾기 전체를 재파싱하는 것과는 별개다. 공식 HTML 플레이어, 안정적인 원본 게시물 주소, 실제 동영상 파일도 모두 재생 관련 필드에 들어 있다는 이유로 일괄적으로 다운로드 가능한 파일로 취급해서는 안 된다.

Kanbox-02 흐름도: 재파싱은 먼저 리비전을 확인하고 허용된 필드만 갱신한다
요청이 나간 뒤 사용자가 내용을 또 고쳤을 수 있다. 응답이 오면 신원, 링크, 수정 시각을 다시 읽어 비교하고, 조건에 맞지 않으면 쓰지 않으며, 저장이 실패하면 이번 갱신 전 내용으로 되돌린다.
테스트에 어떤 페이지를 남겨야 하는가
프로젝트에는 이미 페이지 샘플 파싱 테스트와 모의 네트워크 테스트가 있다. 샤오위저우 테스트는 shownotes, 오디오 필드, 신뢰할 수 없는 미디어 도메인을 확인한다. GitHub 테스트는 저장소 신원 일치와 README 잘림을 확인한다. 네트워크 계층 테스트는 리다이렉트, 3 MiB 상한, 첫 실패 후의 새 요청, 그리고 HTML이 있는 HTTP 오류가 성공 결과로 바뀌지 않는지를 확인한다.
이 테스트들은 필드 추출과 코드 경계를 확인할 수 있지만, 플랫폼이 다음번에 개편된 뒤에도 계속 쓸 수 있다고 보장하지는 않는다. 링크가 깨졌을 때는 실제로 반환되는 것이 정상 콘텐츠인지, 로그인 안내인지, 빈 페이지인지, 오류 응답인지 봐야 한다. 파서를 수정한 뒤에는 기존 샘플과 새 실제 페이지를 함께 확인해야 한다.

Kanbox-02 흐름도: 샘플 테스트와 실제 페이지 확인, 둘 다 남겨야 한다
페이지 샘플을 저장해 두면 필드를 안정적으로 확인하기 좋고, 모의 네트워크는 오류와 재시도를 커버할 수 있다. 플랫폼의 실제 반환값은 여전히 바뀔 수 있으므로 새 페이지 확인이 필요하다. 테스트 통과를 플랫폼이 영원히 쓸 수 있다는 뜻으로 쓴 것은 아니다.
지금은 이렇게 처리한다. 읽을 수 있는 만큼 저장하고, 빠진 것은 설명을 남기며, 사용자에게 기존 내용을 망가뜨리지 않는 재시도 입구를 준다. 플랫폼 제한은 여전히 존재하며, 이 글은 2026년 10월 2일의 구현을 기록한 것이고, 페이지 안의 데이터 구조를 플랫폼이 장기적으로 제공한다고 약속한 API로 취급하지 않는다.