前回の記事では、Kanbox で今できることを紹介した。今回は、共有リンクをどうやってブックマークに変えているかを書く。
まず思いつくのは、ページをリクエストしてタイトルとカバー画像を読む方法だろう。でも、ページを取得したところからが本番だ。本文が HTML の中にあるものもあれば、JSON の中に埋まっているものもある。ログインを促す画面が返ってくることもあるし、共有 URL がそもそも元のアプリを開くためだけのものということもある。
今のところ、この部分のコードは主に LinkResolver.swift と Parsers.swift にある。ここでは小紅書(シャオホンシュ)、豆瓣(ドウバン)、小宇宙(シャオユージョウ)、GitHub を例に、現状の実装を説明する。ログインやアクセス権限を回避する話は扱わない。
まず共有テキストからリンクを抜き出す
他のアプリからコピーしてくるのは、きれいな URL ではなく、たいていこんな文章だ。
イスタンブールの窓には魔法がかかってる!📷 なんだか、いくつもの...
https://xhslink.cn/o/2PMVMYCtPdE
【小紅書】でこのノートを見てみよう!
パーサーの入口では、まず HTTP または HTTPS のリンクを抽出する。プロトコルなしの裸のドメインにも対応している。リンクの後ろに余分な中文の句点や引用符、括弧が付いていたら取り除く。そのままだとアドレスにエンコードされて、存在しないページをリクエストしてしまうからだ。ただし括弧は一律に消してはいけない。URL 自体が括弧を含むことがあるので、余分なものだけを処理する。
クリップボードにも違いがある。プレーンテキストしか書き込まないアプリもあれば、URL 型だけを書き込むアプリもある。今の順番は、リンク付きテキストを探し、次に URL とシステムが認識したウェブアドレスを見る。共有テキストがあるときはなるべく全文を残す。リンクの前の文字列がタイトルの補完に使えるからだ。
このタイトル抽出にネット接続は要らない。ページを取得できなかったときでも、さっき保存したものが何だったかくらいは分かる。ネットから取れた結果にタイトルがあれば、そちらを使う。リンクの後ろにある「〜のアプリで見てみよう」はタイトルにしない。
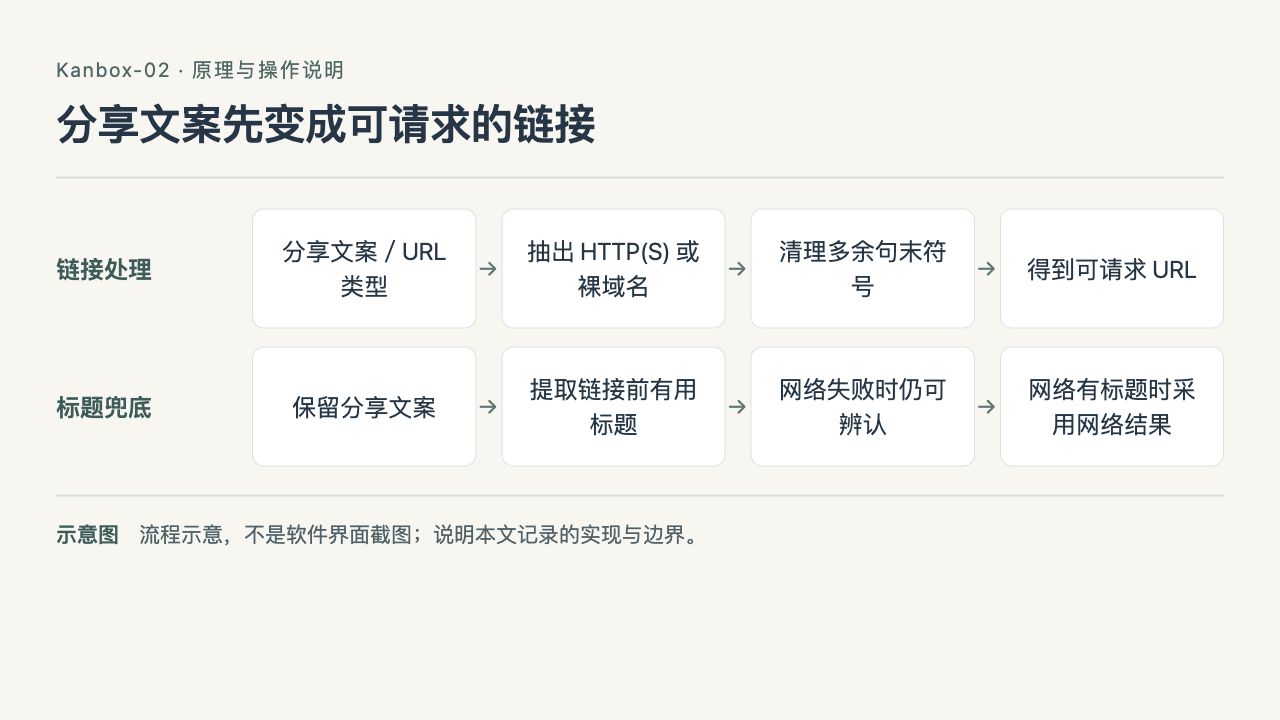
Kanbox-02 フロー図:共有テキストがまずリクエスト可能なリンクになる
余分な句読点を先に掃除するが、URL 内で正当な括弧は消さない。共有タイトルはまずローカルのフォールバックとして使い、ネットからタイトルが取れたらそちらを優先する。
ページを取得して、誰に渡すか決める
小紅書の短縮リンクや一部の共有アドレスはリダイレクトする。リクエストがリダイレクトを追ったあと、最終的なドメインでパーサーを選ぶ。元のアドレスと最終アドレスはそれぞれ保持しておく。
ネットワークリクエストとフィールド抽出は分かれている。LinkResolver がリクエスト、データ補完、失敗処理を担当し、プラットフォーム別パーサーは HTML を受け取って統一の ParsedContent を返す。こうしておけば、小紅書のフィールドを変えるときにネットワーク層を同時に触らなくて済むし、保存済みのページをパーサーに渡してテストもできる。
専用パーサーがない普通のウェブページでは、まず構造化データとタイトル、概要、カバーなどのメタ情報を読む。Open Graphが提供するのはこうしたプレビュー情報で、取得できたからといって記事全体が手に入るわけではない。
記事ページでは、コードが本文の抽出を試みる。優先するのは <article> で、ナビゲーションやフッター、スクリプトを除去してから、文字量、句読点、リンク密度でコンテンツブロックを選ぶ。動的なページによっては外側の構造しかないので、隔離された未ログイン状態の WebKit でページの読み込みを待ってから本文を読む。この汎用パスは、専用パーサーがあるプラットフォームには適用しない。

Kanbox-02 フロー図:ネットワーク層がページを取得し、パーサーがフィールドを取る
リクエスト、プラットフォームの振り分け、フィールド抽出は分離されている。専用パーサーには汎用の本文抽出を適用しない。普通のページはまずプレビューと構造化データを読み、動的な本文だけ隔離・未ログインの WebKit を試す。
4つのプラットフォーム、4つの処理方法
| ソース | 現在の主な読み取り位置 | 補完・フォールバック処理 |
|---|---|---|
| 小紅書 | ページ内のノート初期データ | ノートデータがないときはログイン画面を確認し、必要ならリンクだけ残す |
| 豆瓣 | 公開モバイルの作品ページ | アプリの共有ルートを作品ページにマッピングし、映画はさらにキャスト・スタッフを補完 |
| 小宇宙 | 単一エピソードページの __NEXT_DATA__ | さらに PodcastEpisode データとページメタ情報を試す |
| GitHub | リポジトリページのプレビューと公開 REST API | リポジトリ情報と README を別々に補完。失敗時は既存の結果を保持 |
小紅書:カバーだけでなく、画像セット全体を取る
前回のイスタンブールの写真は11枚あった。カバーのフィールドだけ読んだら、ブックマークには1枚しか残らない。
現在のパーサーは、ページの初期データにあるノートオブジェクトを優先して読み、そこからタイトル、投稿者、本文、トピック、順序付きの画像リストを取る。画像の重複排除では元の順序を保ち、順序のない集合で置き換えたりはしない。
明確なフォールバック条件はこうだ。ページに window.__INITIAL_STATE__ があるのにノートオブジェクトが見つからない場合、ホームのロゴをノートのカバーとして扱うのはやめる。返ってくるのはログインページかもしれないし、削除済みノートのページかもしれないし、外枠だけで本文がない結果かもしれない。このときはリンクを残し、解析の説明も添える。
この初期データがない一部のページだけ、プレビュータグを見にいく。「小紅書」の文字が入った画像が1枚取れたからといって、そのノートの解析が成功した証拠にはならない。
動画は別扱いだ。ページがメディアの位置情報を出しても、再生できるかは使うときに確認する必要がある。1つのアドレスが期限切れになったからといって、すでに保存したタイトルや本文まで一緒に失われてはいけない。
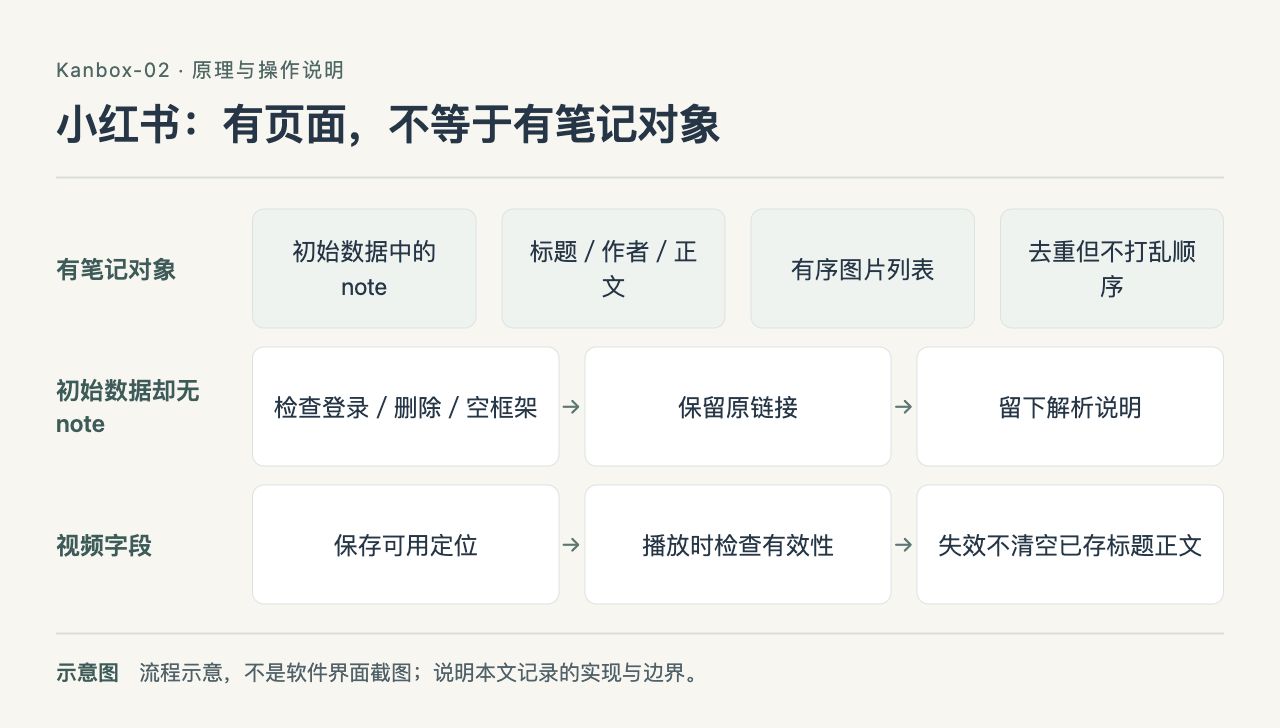
Kanbox-02 フロー図:小紅書:ページがあるからといってノートオブジェクトがあるとは限らない
大事なのは、このノートのデータがあるかどうかで、ページ上に画像があるかどうかではない。画像リストは順序を保つ。ノートオブジェクトがなければリンクと説明を残し、ホームのロゴをカバーにしたりはしない。

Kanbox-02 画面キャプチャ:イスタンブールのノートの11枚の画像ビューア
「イスタンブールの窓には魔法がかかってる!」のブックマークを開くと、画像ビューアは1枚目/全11枚を表示し、この JPEG の寸法とサイズも出している。表示しているのはノート内の元画像で、別途作った共有カードではない。画像セット全体が取れて初めて、1枚ずつ見る、保存する、共有するという入口が生まれる。スクリーンショットはブログ専用のシミュレータにある公開リンクのサンプルから。
豆瓣:共有アドレスがそのまま作品ページとは限らない
『3 Idiots』を例にすると、アプリから共有されるのはこうだ。
https://www.douban.com/doubanapp/dispatch/movie/3793023?dt_dapp=1
この dispatch ページは主にジャンプ用だ。現在のコードは固定のタイプと数字 ID を認識し、豆瓣自身の公開モバイル作品ページをリクエストする。
https://m.douban.com/movie/subject/3793023/
映画名、あらすじ、ポスター、評価、基本情報は作品ページから読む。キャスト・スタッフ一覧は静的ページにそのままのテキストとしてあるわけではなく、このモバイルページが使う公開インターフェースを追加で問い合わせる必要がある。追加取得に失敗したら、すでに読めた映画情報は保持する。
ここで、共有リンクのパラメータにある任意のアドレスをそのままリクエストしてはいけない。今のマッピングは豆瓣のドメイン、認識済みのルート、数字 ID の範囲に限定している。配信停止やエラーページも、ナビゲーション画像が1枚あるからといって映画情報として扱ってはいけない。
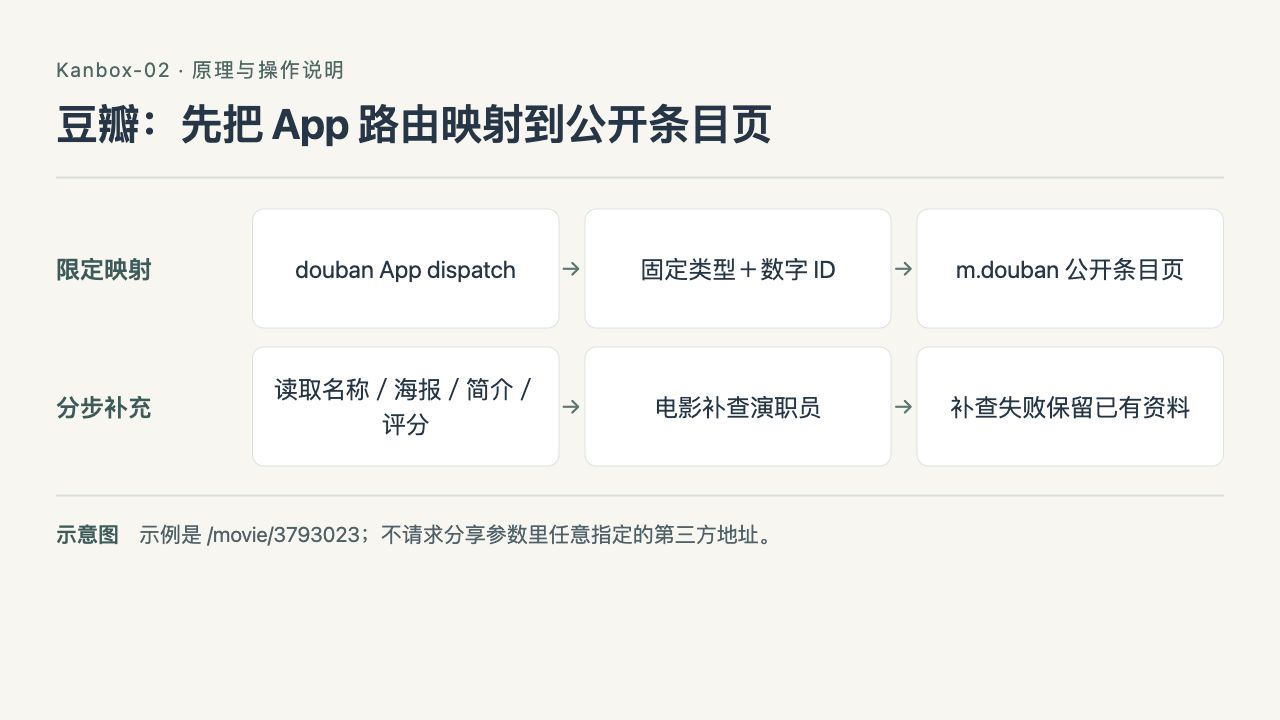
Kanbox-02 フロー図:豆瓣:まずアプリのルートを公開作品ページにマッピングする
認識するのは豆瓣のドメイン、既知のルート、数字 ID だけ。まず作品情報を保存し、それからキャスト・スタッフを補完する。2回目のリクエストが失敗しても、すでに取得した映画情報を空にはしない。
小宇宙:番組説明と音声は別々に保存する
小宇宙の単一エピソードページでは、__NEXT_DATA__ のほうがページ概要よりたいてい完全だ。現在のコードは episode オブジェクトからタイトル、shownotes、番組名、カバー、公開日時、ページが提供する音声アドレスを読む。エピソード ID が取れれば、いまリクエストしている回かどうかも照合する。
shownotes の段落やリストは読みやすいテキストに整える。HTML タグをそのままブックマークに詰め込んだりはしない。このデータがないときは PodcastEpisode 構造化データを試し、最後にページメタ情報へ退避する。
音声は audioUrl に入れ、videoUrl には入れない。どちらもプレイヤーで開けるかもしれないが、ブックマーク一覧で同じ種類のメディアとして表示すべきではない。
タイトルと説明が読めて音声が読めなくても、このエピソードは残せる。ただしオンライン再生アドレスがないことははっきり知らせる。音声アドレスがあるからといってオフライン保存済みというわけでもなく、再生時にはネットワークが必要かもしれない。

Kanbox-02 フロー図:小宇宙:番組テキストと音声は2組のフィールド
エピソード ID で同一性を照合し、まず episode データを読み、次に構造化データとページプレビューを試す。音声が欠けてもこのエピソードは残せるが、ダウンロード済みと表示したり、videoUrl に押し込んだりはできない。
GitHub:ファイル一覧で README を偽装しない
リポジトリのページにはナビゲーション、ファイル一覧、README コンテナがある。大きな HTML をそのままテキストに変換しても、役に立つプロジェクト紹介になるとは限らない。
Kanbox はまずリポジトリの同一性とページプレビューを確認し、それからリポジトリ情報 APIと README APIを別々にリクエストする。公開リポジトリは匿名リクエストでよい。リポジトリ情報は説明、言語、トピック、ライセンス、統計の補完に使い、README は別に保存する。
返ってきた結果は owner とリポジトリ名を照合し、別のプロジェクトを混ぜないようにする。README にも長さ制限があり、切り詰めたときはマークを残す。API が制限されたり README が取れなかったりしても、既存のリポジトリプレビューは空にしない。
この部分は今のところリポジトリのルートアドレス向けだ。Issue やファイルページ、その他の GitHub パスを、そのままリポジトリのルートページとして扱うことはできない。
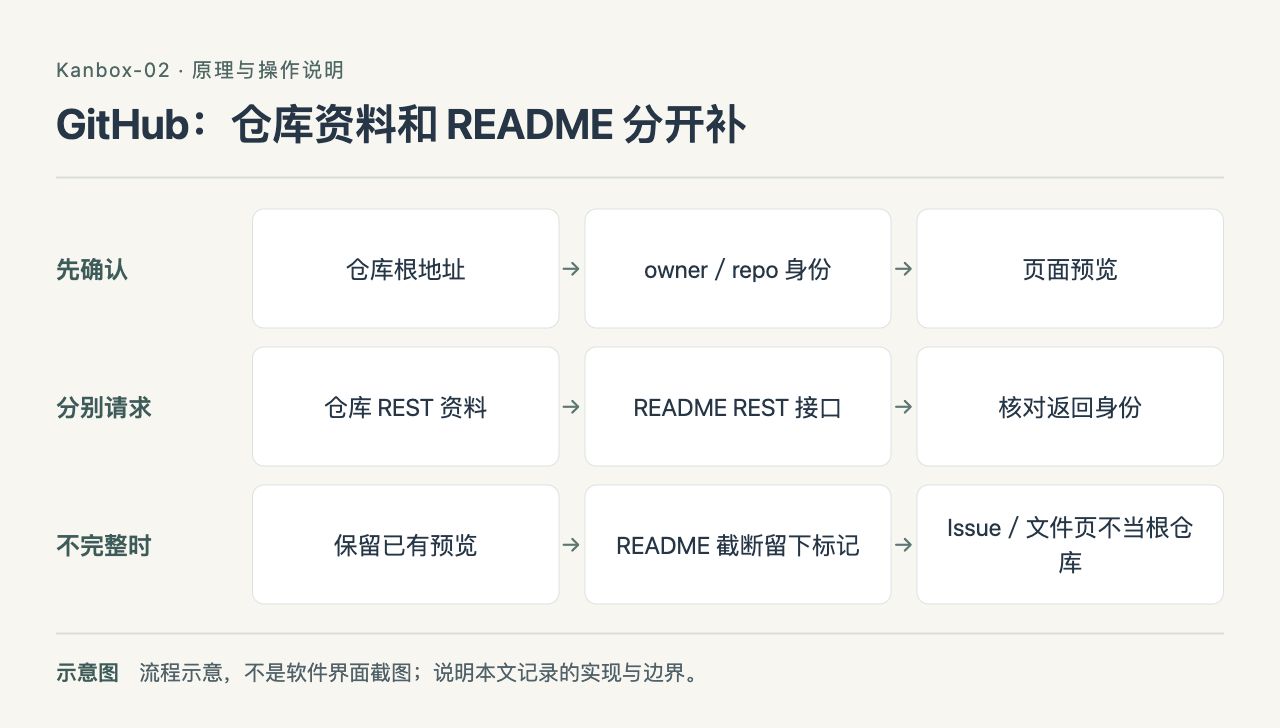
Kanbox-02 フロー図:GitHub:リポジトリ情報と README を別々に補完する
まずリポジトリの同一性を確認し、それから情報と README を別々に補完する。返ってきた結果は owner とリポジトリ名に一致している必要がある。API が制限されてもプレビューは保持し、ファイル一覧で README を装わない。
解析に失敗したとき、ブックマークはどう残すか
統一の解析結果には isResolved と note の2つのフィールドがある。前者はパーサーが使える結果を得たかどうか、後者はメディアの欠落やログインが必要といった状況を記録する。両方を一緒に見る必要がある。isResolved = true でも部分的にしか解析できていないことがあり、すべてのフィールドが揃っているわけではない。
オフライン、タイムアウト、ページにアクセスできないときは、解析層はリンクなどの基本情報だけの結果を失敗理由付きで返す。共有テキストにタイトルがあればそれも補う。設定画面の解析統計も、説明付きの部分結果と説明なしの成功結果を区別する。
HTTP エラーはまず止める。403 や 404 のページにもタイトルや HTML 全体があることがあるが、だからといって「Access Denied」を記事タイトルとして保存したり、失敗のマークを消したりしてはいけない。
1回のページレスポンスは最大 3 MiB まで読む。上限に達したら転送を止める。ファイル全体をダウンロードしてから切り取るのではない。リクエストのタイムアウトは20秒、リソースのタイムアウトは30秒に設定している。これらの制限は1回のネットワークリクエストに対するもので、追加取得を含む全体が20秒以内に終わる保証はない。
解析失敗と保存失敗も分けなければならない。システム共有拡張は結果を App Group の待機キューに書き込む。1件につき1ファイル、アトミックに書き込んでから読み戻して確認する。メインアプリが起動してから SwiftData に書き込み、保存成功を確認してからキューの該当項目を削除する。キューの書き込みやデータベースが失敗したら、やはりエラーを出す。パーサーが結果を返したからといって「保存しました」と表示してはいけない。

Kanbox-02 フロー図:解析結果、キュー書き込み、データベース保存を別々に確認する
解析失敗ならリンクを残してよいが、保存自体の失敗はやはりエラーにする。SwiftData の保存が確認できて初めて、対応する待機ファイルを削除する。「ネットワークが返ってきた」だけで保存済みと表示してはいけない。
再解析でユーザーの編集を上書きしない
詳細ページには手動の再解析入口がある。ネットワークに再リクエストするのであって、前回の失敗結果を再表示するのではない。すでに解析済みの内容も、これで期限切れのメディア情報を更新できる。
ただしリトライで新しい結果をそのままブックマーク全体に上書きしてはいけない。ユーザーがタイトルを変えているかもしれないし、本文を書いているかもしれない。ネットワークの返答を待つ間にまた編集しているかもしれない。
今のやり方はこうだ。リクエスト前にエントリ ID、元リンク、更新時刻を記録する。返ってきたらエントリを読み直し、削除も変更もされていないことを確認してから、更新を許可された解析フィールドを適用する。ユーザーのタイトル、本文、タグ、ブックマーク状態は保持する。新しい結果に画像がなければ古い画像を残し、新しい非空の画像リストがあれば画像リストを更新する。
ネットワーク失敗なら書き込まない。待機中にエントリが変わっていても書き込まない。最後の保存が失敗したら、この更新を適用する前の内容に戻し、リトライを促す。
メディアアドレスにも有効期限がある。たとえば Instagram の一部の動画アドレスは署名付きで、再生や保存の前に同じコンテンツの embed ページを読み直す。これはブックマーク全体の再解析とは別の話だ。公式 HTML プレイヤー、安定した元投稿アドレス、実際の動画ファイルも、再生関連のフィールドにまとめて入っているからといって、一律にダウンロード可能なファイルとして扱ってはいけない。

Kanbox-02 フロー図:再解析はまずリビジョンを照合し、それから許可されたフィールドを更新する
リクエストを出したあと、ユーザーがまた内容を変えているかもしれない。返ってきたら同一性、リンク、更新時刻を読み直して比較する。条件を満たさなければ書き込まず、保存に失敗したらこの更新前の内容に戻す。
テストに残すべきページ
プロジェクトにはページサンプルの解析テストと模擬ネットワークテストがすでにある。小宇宙のテストは shownotes、音声フィールド、信頼できないメディアドメインを確認する。GitHub のテストはリポジトリの同一性照合と README の切り詰めを確認する。ネットワーク層のテストはリダイレクト、3 MiB 上限、最初の失敗後の新規リクエスト、HTML 付きの HTTP エラーが成功結果にならないことを確認する。
これらのテストはフィールド抽出とコードの境界を確認できるが、プラットフォームが次に改版しても動く保証はない。リンクが無効になったときは、実際に返ってくるのが正常な内容か、ログイン画面か、空ページか、エラー応答かを見る必要がある。パーサーを変更したら、古いサンプルと新しい実ページの両方を確認する。

Kanbox-02 フロー図:サンプルテストと実ページ確認、どちらも残す
ページサンプルを保存すればフィールドを安定して確認でき、模擬ネットワークはエラーとリトライをカバーできる。プラットフォームの実際の戻り値は変わりうるので、新しいページでの確認が必要だ。テストが通ったからといって、プラットフォームが永遠に使えると書いたわけではない。
今のところはこう処理している。読めるだけ保存し、足りないものは説明を残し、ユーザーには古い内容を壊さないリトライ入口を渡す。プラットフォームの制限は依然としてある。この記事は2026年10月2日時点の実装の記録であり、ページ内のデータ構造をプラットフォームが長期的に提供する API とみなすものではない。